Die Kurzfassung
- Keine Entschlüsselung. Substitutionschiffren (Buchstabe für Buchstabe, auf Wortebene vom „Naibbe“-Typ, mit Glyphengruppen, mit Gedächtnis, mit entfernten Füllzeichen) scheiterten in Latein, Italienisch, Deutsch, Mittelhochdeutsch, Altgriechisch, Altokzitanisch, Altfranzösisch und Katalanisch – während dieselben Angriffe meine eigenen verschlüsselten Kontrolltexte mit 94–100 % Genauigkeit knackten.
- „Es liest sich wie Latein“ ist eine Falle. Gemischter Voynich-Text liefert ebenso lateinisch wirkende Ausgaben. Jeder Angriff wurde an dieser Basislinie gemessen.
- Voynich-Wörter kopieren ihre Nachbarn. Ein Wort ist 1,36–1,38× häufiger eine um eine Glyphe abweichende Variante eines Wortes aus der Zeile darüber als eines Wortes aus einer zufälligen Zeile. Gewöhnliche Prosa, ob Klartext oder verschlüsselt: 1,03–1,12×. Generierter Text und Namenslisten aus Zauberbüchern: 1,58–1,68×.
- Positionsabhängige Chiffren sind ausgeschlossen. Vigenère, progressive Chiffren, laufende Schlüssel (auch mit Bibeltext) und Schlüssel pro Seite glätten den Text; Voynich ist repetitiver und vorhersagbarer als lateinischer Klartext.
- Die Bilder verweisen aufeinander, der Text nicht. Pflanzen aus dem Pharmateil tauchen im Kräuterteil wieder auf – ihre Beschriftungen aber nicht auf den passenden Seiten des Kräuterteils.
- Kein Quelltext, keine Musik, kein Reim, nichts durch das Blatt hindurch. Der Badeteil ist kein verschlüsseltes De balneis Puteolanis, der Rezeptteil nicht das Antidotarium Nicolai – geprüft mit Tests, die die echte Quelle in 100 % der Simulationen fanden. Als Notenschrift gelesen, bewegen sich die Glyphen nicht wie Melodien des 14. Jahrhunderts, die Zeilen reimen sich nicht, und Text, der auf den beiden Seiten eines Blattes übereinanderliegt, hängt nicht zusammen (zum Ausprobieren: der Durchlicht-Betrachter).
1 · Das Manuskript in 60 Sekunden
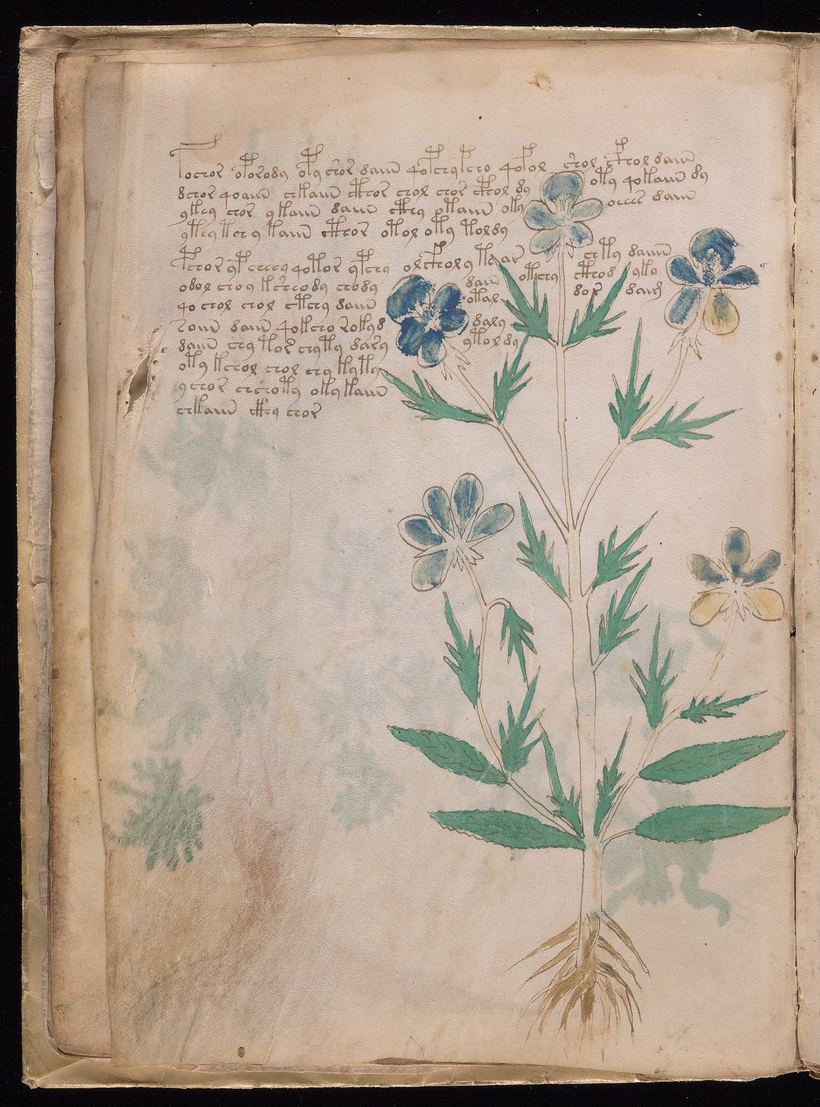
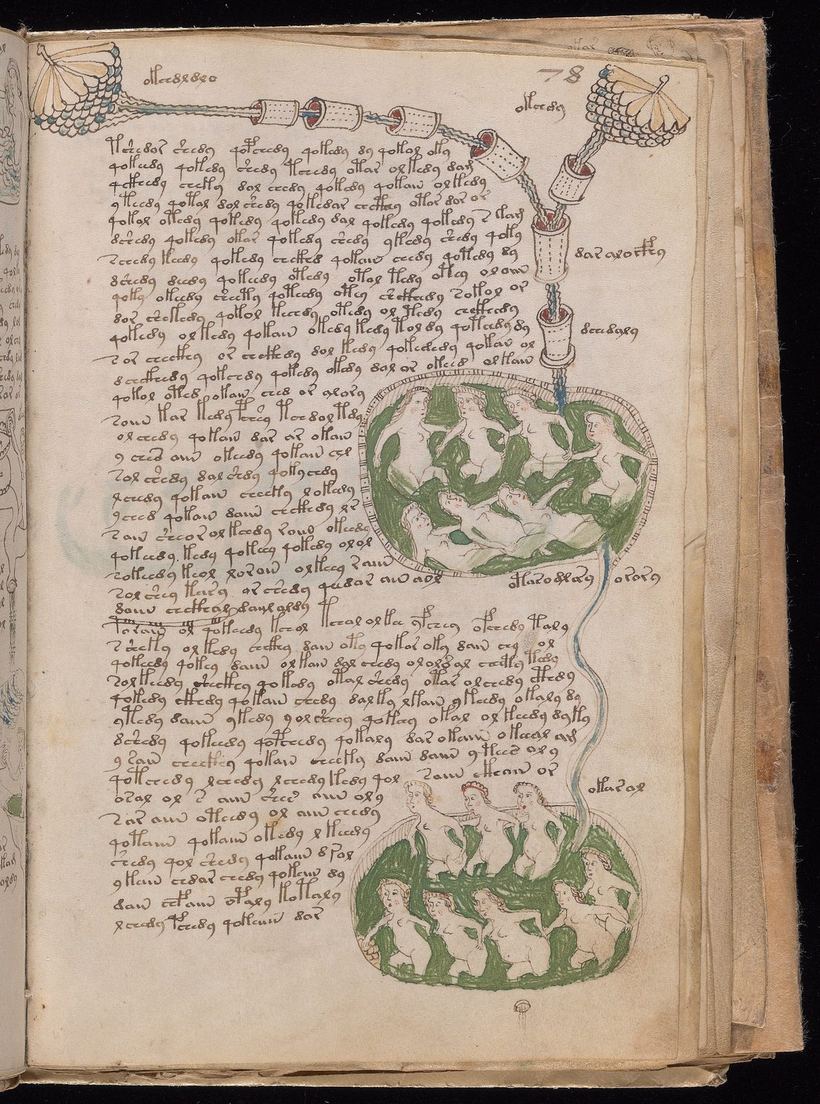
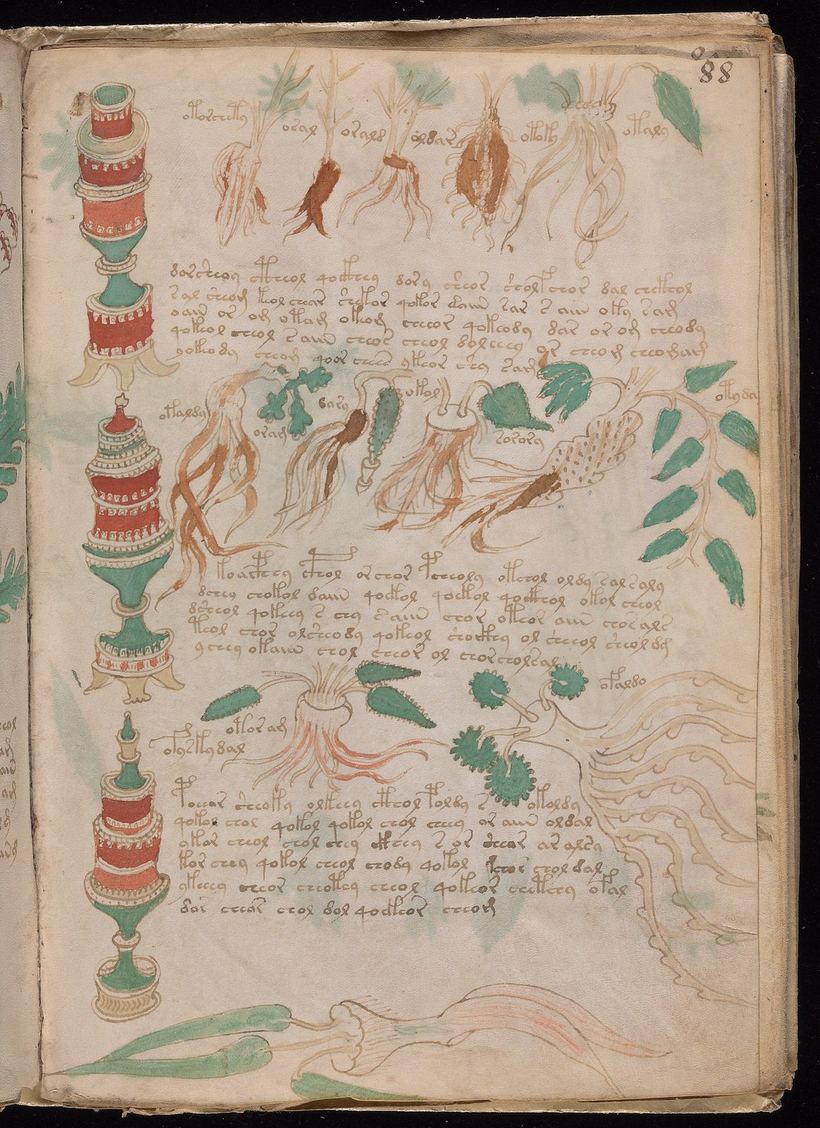
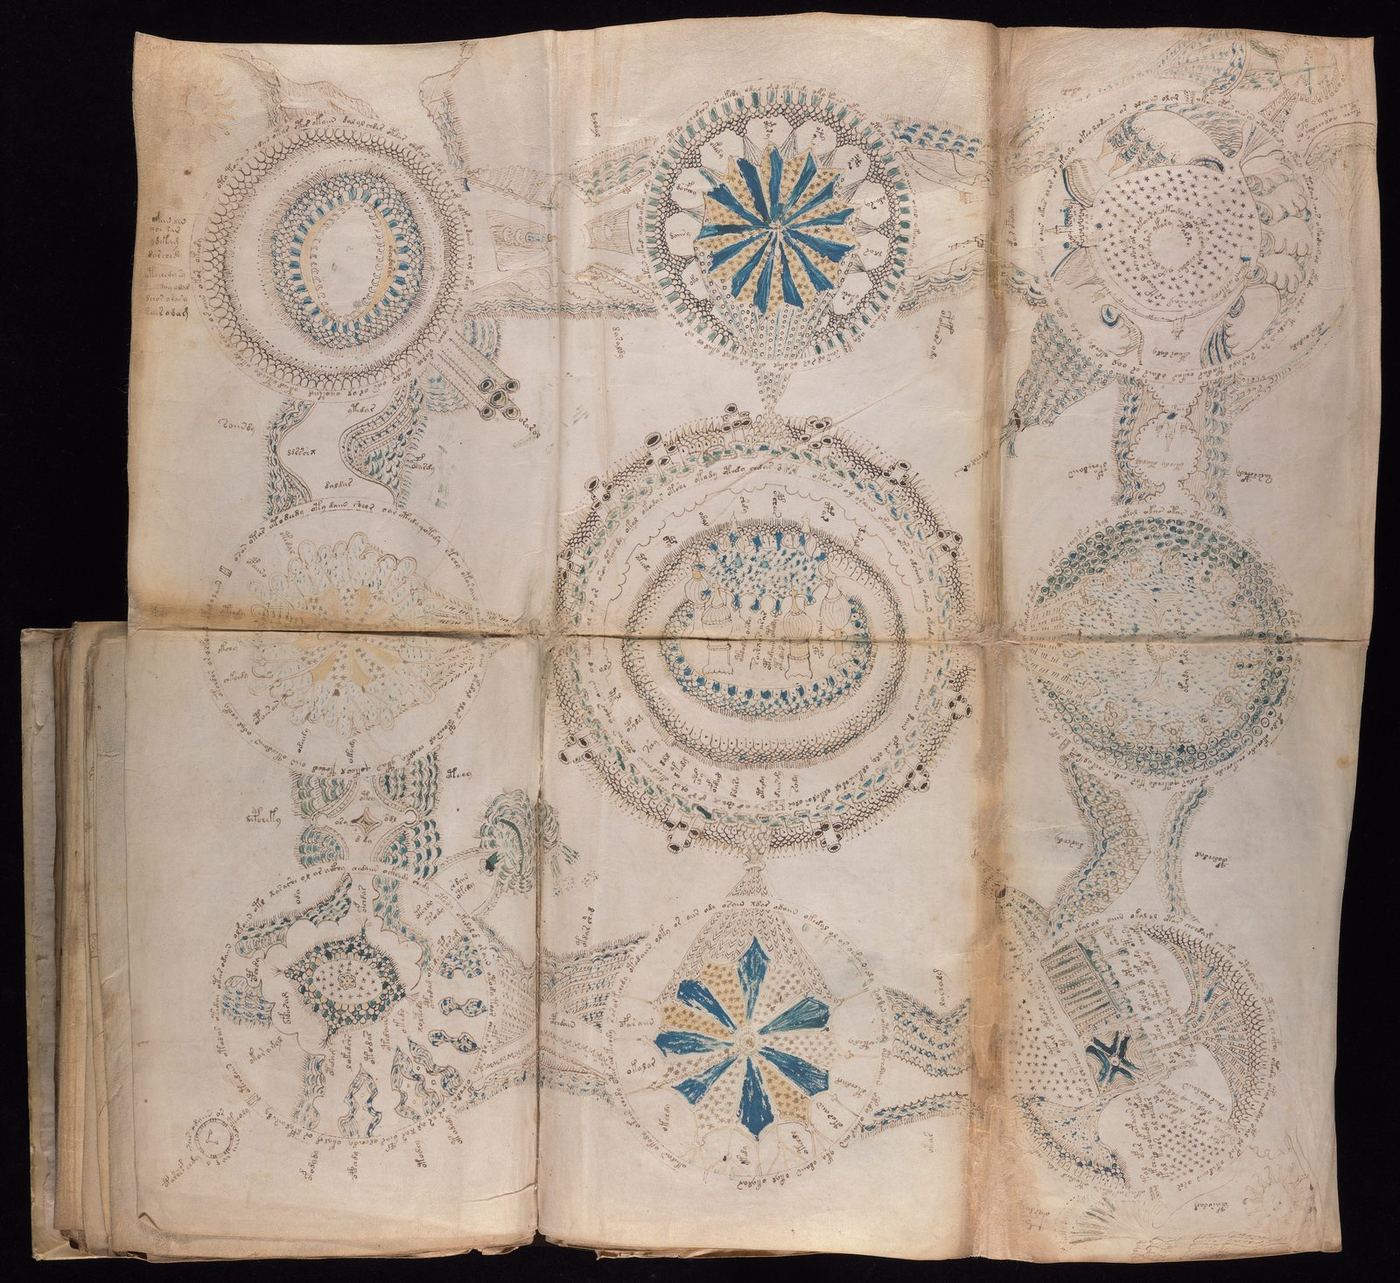
Das Voynich-Manuskript (Yale, Beinecke MS 408) ist ein kleiner illustrierter Kodex mit rund 240 erhaltenen Seiten in einer unbekannten Schrift. Sein Pergament wurde per Radiokarbonmethode auf 1404–1438 datiert. Die Abschnitte zeigen Pflanzen, astronomische und Tierkreis-Diagramme, badende Frauen, die durch Röhren verbunden sind, Apothekergefäße mit Pflanzenteilen und schließlich Seiten mit kurzen, sternmarkierten Absätzen. Die Forschung transkribiert die Schrift mit dem EVA-Alphabet (z. B. daiin, qokeedy, chedy). Prescott Currier bemerkte in den 1970er-Jahren, dass der Text in zwei statistischen „Dialekten“ vorliegt, Currier A und B; ich analysiere sie getrennt.
2 · Wie die Tests funktionieren
Das Feld ist voller „Entschlüsselungen“, die sich schön lesen und nichts bedeuten. Deshalb hat jeder Test hier zwei Kontrollen:
Der Angriff selbst ist ein Löser für homophone Substitution (Simulated Annealing mit Neustarts). Er sucht den Schlüssel, unter dem der Text einer bestimmten Sprache am ähnlichsten sieht, bewertet mit einem 5-Gramm-Zeichenmodell dieser Sprache, trainiert auf 0,08–8,6 Millionen Zeichen je Sprache. Der Score ist die mittlere Log-Wahrscheinlichkeit pro Zeichen: höher heißt sprachähnlicher. Ein echter Durchbruch zeigt sich als Sprung von etwa +0,5 oder mehr über die gemischte Basislinie (so groß war der Abstand bei den Positivkontrollen) und als lesbarer Text.
Der Ausgangspunkt: die Naibbe-Chiffre
2025 veröffentlichte Michael Greshko die Naibbe-Chiffre: eine von Hand ausführbare, aufblähende homophone Chiffre (Spielkarten und Würfel wählen zwischen Tabellen; jedes Voynich-ähnliche Wort kodiert einen oder zwei Klartextbuchstaben). Sie reproduziert viele Voynich-Statistiken verblüffend gut. An einer scheitert sie jedoch:
Voynich vs. Naibbe vs. echte Sprachen
h1/h2: Zeichenentropie und bedingte Entropie in Bit, berechnet mit Wortzwischenräumen; „Type/Token“: verschiedene Wörter je Token in den ersten 10.000 Wörtern; „Wortgrenzen-Abhängigkeit“: Transinformation zwischen der letzten Glyphe eines Wortes und der ersten Glyphe des nächsten (Bit); gemischte Basislinie ≈ 0,004–0,018.
| Text | h1 | h2 | Ø Wortlänge | Type/Token | Häufigstes Wort | Wortgrenzen-Abhängigkeit |
|---|---|---|---|---|---|---|
| Voynich B | 3,87 | 2,00 | 5,16 | 0,241 | 2,1 % | 0,238 |
| Voynich A | 3,83 | 2,14 | 4,85 | 0,299 | 4,6 % | 0,124 |
| Naibbe-Chiffre (lateinischer Plinius) | 3,88 | 2,08 | 5,23 | 0,298 | 2,3 % | 0,006 |
| Latein (Secretum secretorum) | 3,95 | 3,27 | 5,66 | 0,316 | 9,8 % | 0,045 |
| Deutsch (Luther 1545) | 3,88 | 3,12 | 4,42 | 0,158 | 6,9 % | 0,089 |
3 · Chiffre-Angriffe in acht Sprachen
Angegriffen wurden vier Chiffre-Familien, jeweils in bis zu acht Kandidatensprachen und für Currier A und B. Das Diagramm zeigt den Zugewinn gegenüber der gemischten Basislinie (Score des echten Voynich-Textes minus Score des gemischten Voynich-Textes; jeweils der beste aller Läufe auf beiden Seiten). Auswahl des Chiffre-Modells:
Voynich gegen die eigene gemischte Kopie
Zugewinn an Log-Wahrscheinlichkeit pro Zeichen. Im grauen Band (±0,2) liegt das Suchrauschen; die Linie bei +0,5 markiert den typischen Abstand, wenn eine Chiffre tatsächlich gebrochen ist (Positivkontrollen).
Die Kontrollen funktionierten
| Chiffre-Modell | Kontrolltexte (von mir verschlüsselt) | Schlüssel zurückgewonnen |
|---|---|---|
| Wortebene, aufblähend (Naibbe-Typ) | Plinius (Latein), Parzival (Mhd.), Galen (Griechisch), Okzitanisch, Altfranzösisch, Katalanisch | 94–97 % |
| Glyphengruppen = Buchstaben | dieselben sechs Sprachen, 39–120 Chiffresymbole | 100 % |
| Glyphengruppen + Gedächtnis | Latein, das vorige Wortende wählt 1 von 6 Alphabeten | 99 % |
| Wortebene + Gedächtnis | Latein | nicht entscheidbar* |
* Mit ~3.700 Chiffresymbolen ist der Voynich-Text zu kurz: Selbst bei der Kontrolle erzielen falsche Schlüssel einen besseren Score als der richtige (−2,53 gegenüber −2,61). Das ist eine Grenze der Methode, kein Ergebnis über das Manuskript.
Die Falle „klingt wie Latein“
Ein Optimierer findet immer eine Ausgabe, die vage nach der Zielsprache aussieht. Zum Vergleich:
Nur die Kontrolle ist echtes Latein (Plinius, Naturalis historia 15: „pomiferae arbores quaeque mitioribus sucis voluptatem primae cibis attulerunt…“). Die Voynich-Ausgaben sind Rauschen mit lateinischem Anstrich – und der gemischte Voynich-Text schneidet genauso gut ab. Viele veröffentlichte „Lösungen“ stellen diesen Vergleich nie an.
4 · Wörter, die mit ihren Nachbarn reden
Im Voynich-Text sagt das Ende eines Wortes den Anfang des nächsten voraus – weit stärker als in jeder getesteten natürlichen Sprache. Auf ein Wort, das auf -y endet, folgt 1,76× häufiger als zufällig ein Wort, das mit q- beginnt; -r → a- 3,1×, -s → a- 4,9×. Eine Chiffre, die jedes Wort unabhängig verschlüsselt (wie Naibbe), kann das nicht erzeugen. Eine Chiffre mit Gedächtnis kann es: Wählt das Ende des vorigen Wortes die Tabelle für das nächste Wort, schießt der Effekt sogar über.
Wie stark das Ende eines Wortes den Anfang des nächsten vorhersagt
Transinformation zwischen der letzten Glyphe und der ersten Glyphe des nächsten Wortes, in Bit.
5 · Beinahe-Kopien: der Selbstzitat-Test
Torsten Timm und Andreas Schinner schlugen vor, dass der Text durch Kopieren und leichtes Abwandeln früherer Wörter auf der Seite erzeugt wurde. Ich habe eine einfache, modellfreie Vorhersage getestet: Wie oft ist ein Wort eine um eine Glyphe abweichende Variante eines Wortes in der Zeile direkt darüber – verglichen mit einer zufälligen Zeile ähnlicher Länge von einer anderen Seite? 1,0× bedeutet keine Präferenz.
Beinahe-Kopien mit einer Glyphe Abweichung aus der Zeile darüber (Verhältnis zu einer zufälligen Zeile)
Mittelwerte über 5 Zufalls-Seeds (±0,02–0,05). Referenzlinie bei 1,0 = kein lokales Kopieren.
Der Effekt nimmt mit dem Abstand ab
Beinahe-Kopie-Verhältnis beim Vergleich mit der Zeile 1, 2, 4 oder 8 Zeilen darüber. Werte erscheinen beim Überfahren mit der Maus.
Das Ergebnis gilt auch innerhalb eines einzelnen Abschnitts des Manuskripts (Kräuterteil, Badeteil, Sternenteil: 1,20–1,31×), es liegt also nicht nur am themenbezogenen Wortschatz. Der interessanteste Vergleich stammt aus einem Zauberbuch, dem Sworn Book of Honorius (Liber Iuratus, mittelenglische Fassung): Seine Prosaseiten erreichen 1,17×, seine Seiten mit Listen erfundener Engelnamen („lafyel mazyel memyell paryel toupyel…“) dagegen 1,58×. Voynich liegt zwischen Prosa und solchen Listen. Sowohl „generierter Unsinn“ als auch „Kataloge systematisch gebildeter Namen oder Begriffe“ bleiben vereinbar; gewöhnliche verschlüsselte Prosa nicht.
6 · Positionsabhängige Chiffren
Was, wenn dieselbe Glyphe an verschiedenen Stellen verschiedene Buchstaben bedeutet – eine Chiffre vom Vigenère-Typ oder mit laufendem Schlüssel, ein neues Alphabet pro Seite oder ein Schlüssel, der aus einem ganzen Text abgeleitet ist (z. B. aus einer Bibelstelle)? Ich habe denselben lateinischen Text auf sechs solche Arten verschlüsselt und ihre statistischen Fingerabdrücke mit Voynich verglichen.
Fingerabdrücke positionsabhängiger Chiffren
Jedes Feld zeigt ein Maß; Voynich ist hervorgehoben. Positionsabhängige Chiffren verschieben jedes Maß in die entgegengesetzte Richtung wie Voynich.
- Keine Periode. Bei der Suche nach jeder Periode von 2 bis 40 (Glyphen und Wörter) liegt das stärkste Voynich-Signal bei z = 1,9 (B) / 3,0 (A) – Rauschniveau (lateinischer Klartext erreicht zufällig 3,6). Kontrollen: Vigenère mit Periode 7 ergibt z ≈ 7.100; vier leicht unterschiedliche Alphabete im Wechsel ergeben z ≈ 780.
- Gleiche Bedeutung auf jeder Seite. 85 % der Wörter einer Voynich-B-Seite kommen unverändert auf anderen Seiten vor (Latein: 81 %; neues Alphabet pro Seite: 23 %).
- A und B sind nicht zwei Schlüssel. 75 % der Currier-A-Wörter kommen unverändert in B vor; nach einem Tausch der Glyphen nach Häufigkeitsrang (was ein Schlüsselwechsel erfordern würde) nur 3 %.
Es gibt einen starken Positionseffekt – aber er hängt an der Zeile, nicht an der Position im Buch:
Erste Glyphe eines Wortes: Zeilenanfang gegenüber Zeilenmitte (Voynich B)
Anteil der Wörter, die mit der jeweiligen Glyphe beginnen. Die Zeilenposition erklärt 0,119 Bit der ersten Glyphe in Voynich B, 0,000 in Latein.
Jede Zeile verhält sich wie eine Einheit mit eigenen Eröffnungsregeln. Eine Chiffre mit einem Sonderalphabet am Zeilenanfang war Teil des Gedächtnis-Modells oben – ebenfalls negativ.
Ist die Glyphe am Zeilenanfang ein Schlüsselindikator?
Leon Battista Alberti (1467) fügte einen Großbuchstaben ein, um dem Leser anzuzeigen, dass die Chiffrierscheibe gedreht worden war. Könnten die besonderen Glyphen am Zeilenanfang diese Rolle spielen und das Alphabet für den Rest der Zeile umschalten? Dann würde die erste Glyphe einer Zeile die Glyphenmischung im Rest der Zeile vorhersagen. Das tut sie – aber nur schwach: 0,0086 Bit in Voynich B (z = 25; Indikatoren innerhalb von Seite und Absatzposition gemischt), 0,0038 in A, verglichen mit 0,002–0,003, wenn ein beliebiges anderes Wort der Zeile als „Indikator“ dient. Ein echter Schlüsselwechsel ist 35–65× stärker: 0,31 Bit selbst dann, wenn sich die Alphabete nur um drei vertauschte Buchstabenpaare unterscheiden, 0,56 Bit bei voneinander unabhängigen Alphabeten. Der Effekt beruht vor allem auf einer Glyphe: Zeilen, die mit einem der Galgenzeichen p, t oder k beginnen, enthalten 1,8–3,4× mehr p – das bekannte Muster der „galgenzeichenreichen ersten Zeile“, kein Schlüsselwechsel.
7 · Was die Bilder verraten
Die Bilder sind die einzige mögliche Quelle für bekannten Klartext („Cribs“) – und zugleich die Quelle der meisten gescheiterten Entschlüsselungen: Eine Pflanze wird „identifiziert“, ihre Beschriftung „gelesen“, und die Lesung scheitert auf der nächsten Seite. Deshalb habe ich nur Bildhinweise verwendet, die sich testen ließen.
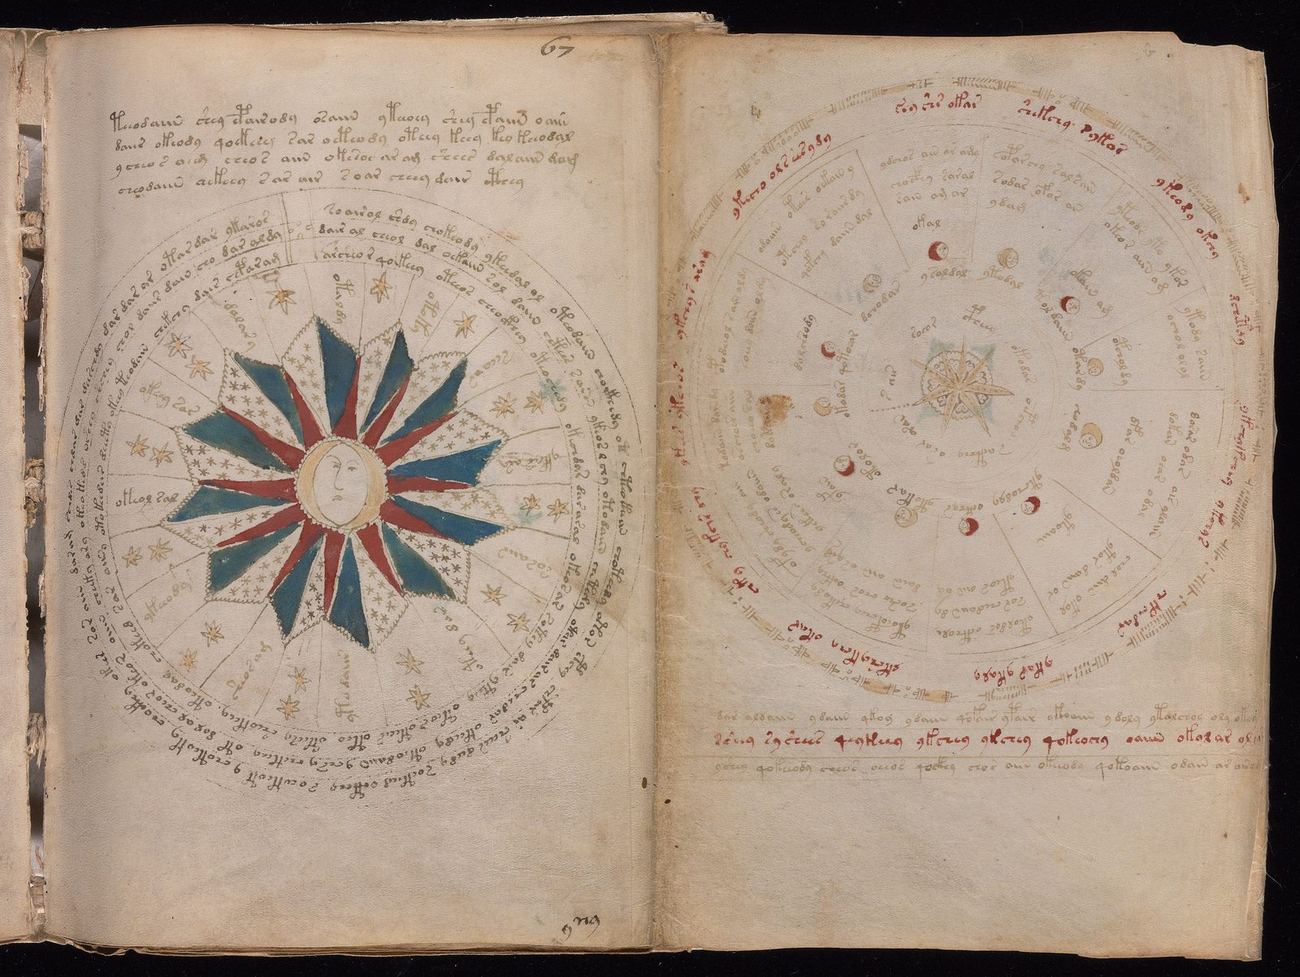
Tierkreis-Beschriftungen sind keine Tageszahlen
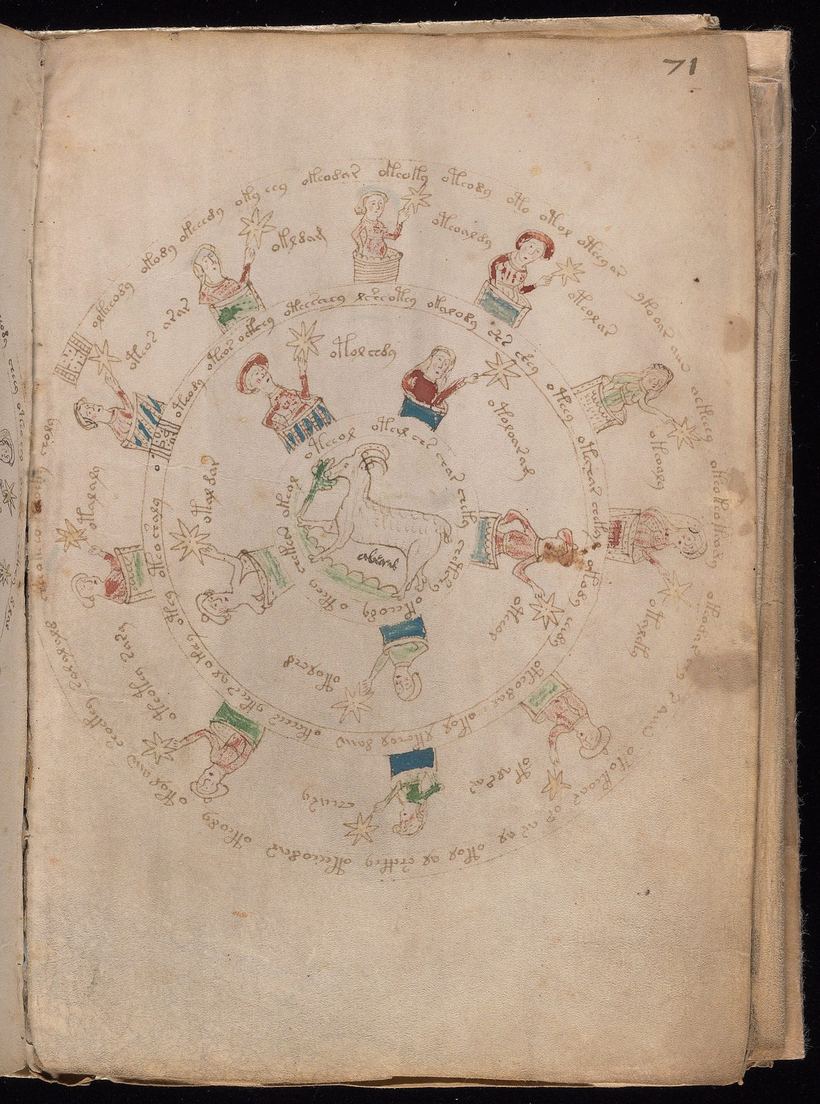
Die 12 Tierkreisseiten zeigen je 15–30 Frauen, insgesamt 295 beschriftete Figuren. Eine naheliegende Idee: 30 Figuren = 30 Tage oder Grade des Zeichens, die Beschriftungen wären also Zahlen. Wären es Zahlen in einer Chiffre vom Naibbe-Typ, würden sich viele Beschriftungen über die Seiten hinweg wiederholen.
Auch die Reihenfolge der Beschriftungen rund um den Ring zeigt keine Übereinstimmung von Seite zu Seite (0,401 gegenüber 0,403 ± 0,002 bei Zufall). Der häufige Anfang ot-/ok- ist die einzige echte Struktur – ein gemeinsames erstes Wort („stella…“?) oder eine Beschriftungskonvention. Und die Einwort-Beschriftungen sind ein Problem für Naibbe: Ein Stern- oder Pflanzenname passt nicht in einen oder zwei Buchstaben.
Pharma-Pflanzen tauchen im Kräuterteil wieder auf – ihre Beschriftungen nicht
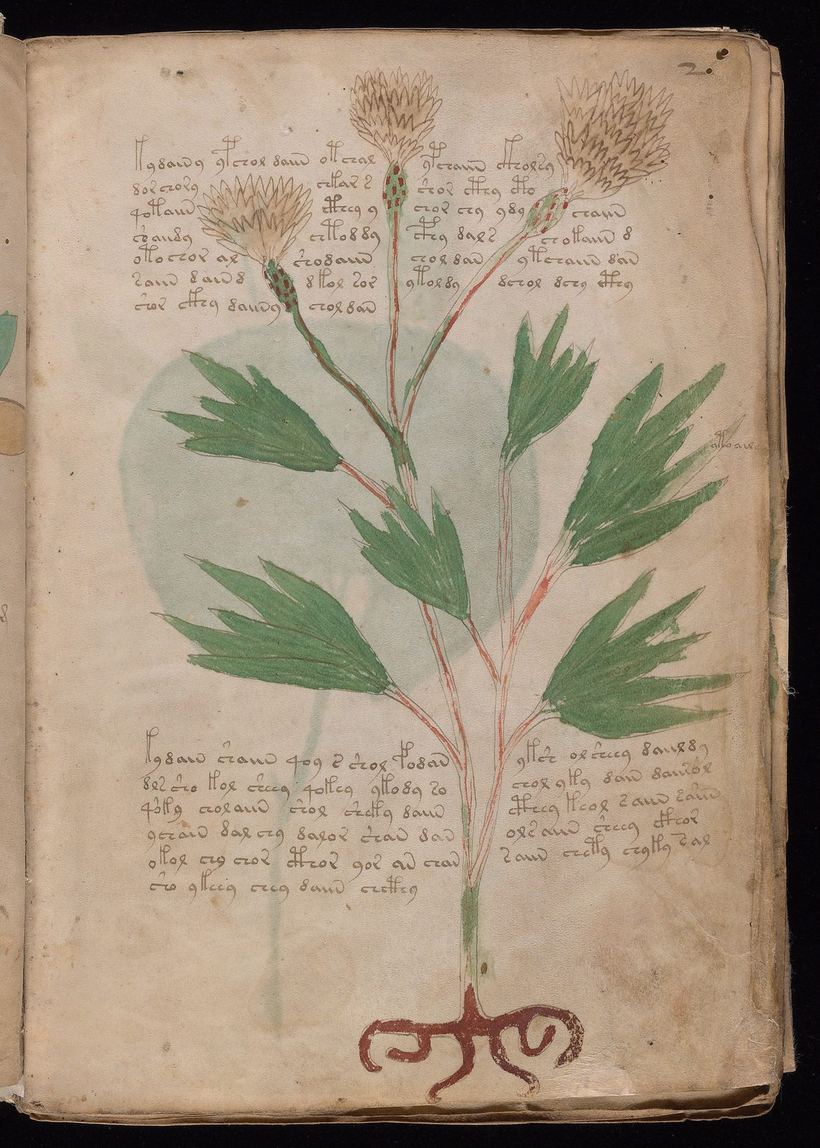
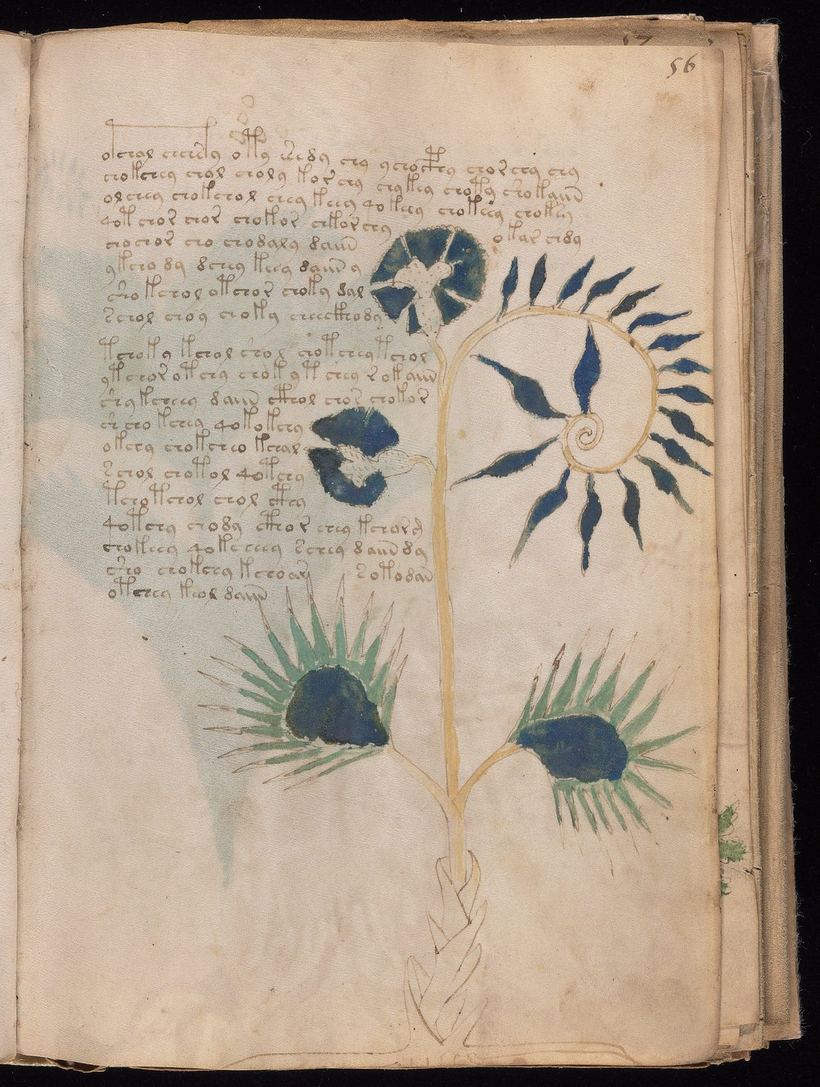
Ich habe alle 12 Seiten des Pharmateils mit allen 130 Seiten des Kräuterteils nur anhand der Bilder verglichen und die Liste der Übereinstimmungen festgelegt, bevor ich irgendeinen Text angesehen habe. Die deutlichste Übereinstimmung:
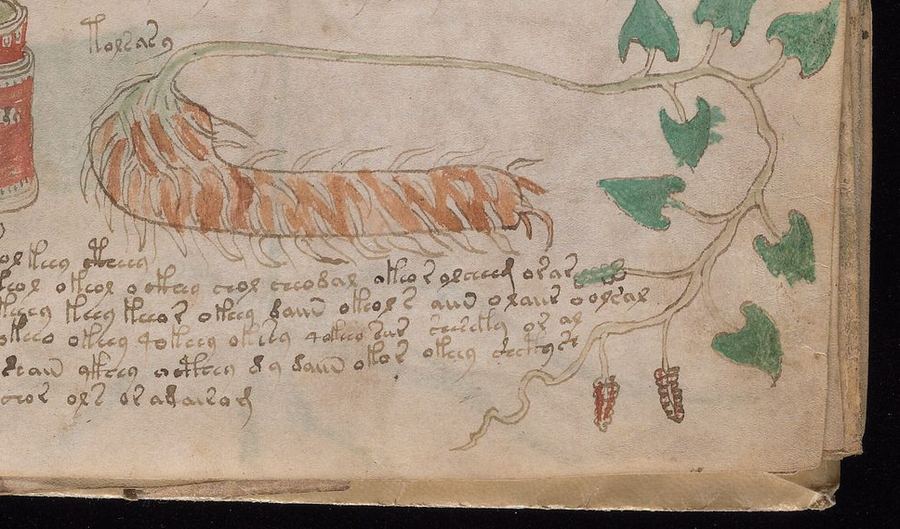
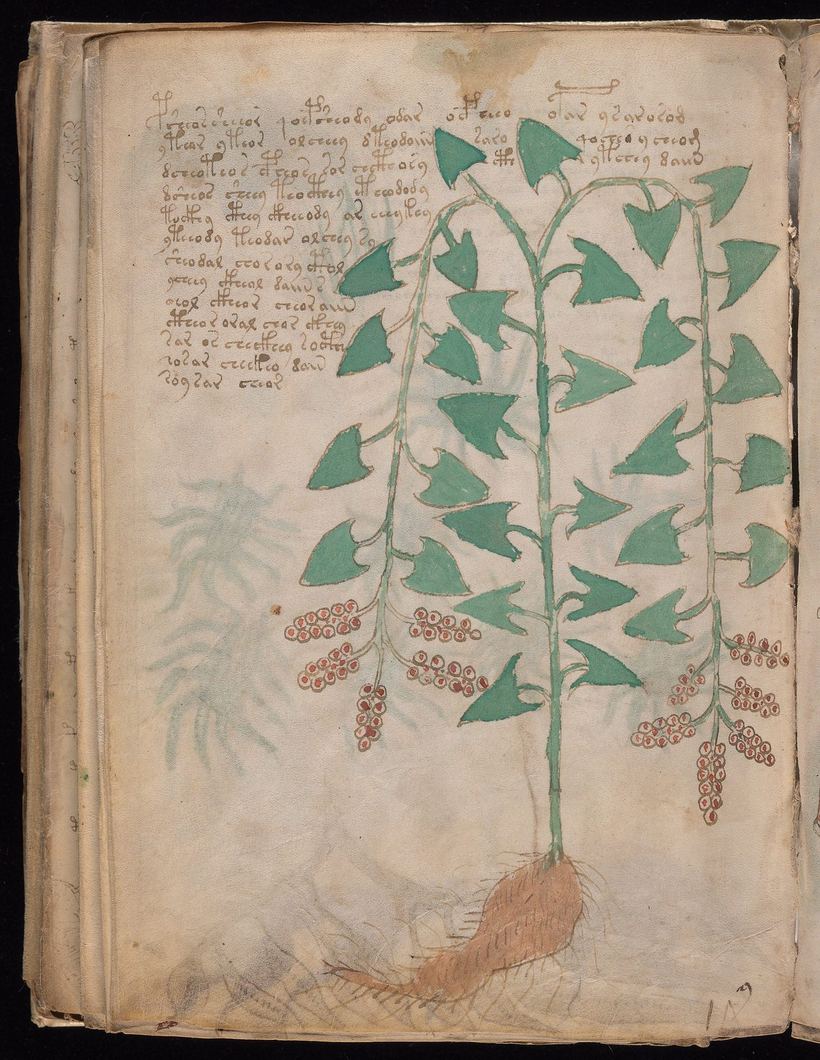
Insgesamt elf Übereinstimmungen (1 mit hoher, 6 mit mittlerer, 4 mit niedriger Sicherheit). Die beiden stärksten verbinden beide f99 mit f96 – Seiten, die im Buch nahe beieinanderliegen. Der Illustrator hat Pflanzen absichtlich wiederverwendet. Dann der Test: Kommen die Beschriftungen einer Pharma-Seite auf der passenden Kräuterseite häufiger vor als auf vergleichbaren Seiten derselben Currier-Sprache und Länge?
Die „Treffer“ waren nur Allerweltswörter (chol, cheol, char, chor, otor). Hätten alle sieben guten Übereinstimmungen ihren Namen auf der Kräuterseite getragen, hätte der Test das gezeigt (p = 0,016). Das spricht gegen Systeme mit fester Schreibung (Klartext, einfache Substitution, Codebücher), in denen der Text des Kräuterteils die Pflanze mit dem Wort der Pharma-Beschriftung benennt – während eine Chiffre, die dasselbe Wort jedes Mal anders schreibt, Beschriftungen, die keine Namen sind, oder bedeutungsloser Text weiterhin möglich bleiben.
8 · Zwei mögliche Quelltexte
Verschlüsselt das Voynich-Manuskript einen bekannten mittelalterlichen Text, sollten die Längen der Abschnitte dieses Textes in derselben Reihenfolge in den Längen der Voynich-Absätze wiederkehren – unabhängig von der Chiffre, solange sie die Länge grob erhält. Zwei Kandidaten passen zu den Bildern:
- De balneis Puteolanis von Petrus de Ebulo (um 1220): lateinische Epigramme über die Bäder bei Neapel, mit Badebildern bis weit ins 15. Jahrhundert abgeschrieben – für den Badeteil (f75–f84).
- Das Antidotarium Nicolai (Salerno, 12. Jahrhundert): das Standard-Arzneibuch des Mittelalters, alphabetisch geordnete Rezepte – für den sternmarkierten Rezeptteil (f103–f116).
Ein Alignment per dynamischer Programmierung ordnet jeden Quellabschnitt 1–4 aufeinanderfolgenden Voynich-Absätzen zu, sodass die Längen möglichst gut übereinstimmen (beim Antidotarium auch mit zwei Rezepten pro Gruppe, freiem Anfang und Ende sowie einer Lücke für das verlorene Doppelblatt f109–f110). Der p-Wert vergleicht die echte Reihenfolge der Quelle mit denselben, aber gemischten Abschnittslängen. Als Positivkontrolle habe ich die echte Quelle in einer Simulation verschlüsselt – mit geteilten und zusammengelegten Absätzen und Längenrauschen – und geprüft, dass der Test sie findet.
| Kandidat | Voynich-Abschnitt | Voynich p | Test findet die echte Quelle | Urteil |
|---|---|---|---|---|
| De balneis Puteolanis 34 Abschnitte, 14.103 Buchstaben; fast alle 12 Verse (±6 %) | Badeteil, 82 Absätze, 31.035 Glyphen | 0,72 nur Bäder: 0,86 | 100 % bei ±5 % Längenrauschen | ✕Ausgeschlossen |
| Antidotarium Nicolai, Venedig 1471 135 Rezepte, 16.929 Wörter; je 91–2.326 Buchstaben | Rezepte, 283–291 Absätze, 10.457 Wörter | 0,28–0,75 8 Varianten | 100 % bis ±50 % Änderung pro Rezept | ✕Ausgeschlossen |
| … als Auswahl 35 % der Rezepte zufällig ausgelassen | wie oben | 0,36–0,80 | 58 % | !Keine Stütze |
Varianten: Reihenfolge des Drucks von 1471 oder der mittelniederländischen Handschrift von 1351; Voynich-Absätze nach den Absatzmarken der Transkription oder zusätzlich an Zeilen geteilt, die mit den Galgenzeichen p/f beginnen (Sterne sind nicht transkribiert); Längen in Buchstaben/Glyphen oder Wörtern.
Keiner der beiden Texte steckt als Ganzes in diesen Abschnitten. Nicht ausgeschlossen sind: eine stark gekürzte Auswahl, eine Chiffre, die Längen zufällig aufbläht, oder Absatzumbrüche, die die Struktur der Quelle ignorieren.
9 · Ist es Musik – oder sind es Verse?
Zwei letzte Ideen von außerhalb der Kryptografie. Musik: Um 1400 wurden Tonhöhen auch mit Buchstaben notiert (guidonische Buchstaben, Orgeltabulaturen). Wäre jede Glyphe eine Note, müsste sich der Text wie eine Melodie bewegen. Dichtung: Voynich-Zeilen verhalten sich wie Einheiten mit eigenen Eröffnungsregeln (Abschnitt 6) – genau das, was zu erwarten wäre, wenn jede Zeile ein Vers wäre. Gereimte Verse hinterlassen eine Spur, die viele Chiffren übersteht: Zeilenenden passen zu ihren Nachbarn.
Der Melodietest
Für jeden Text habe ich die Anordnung seiner Symbole gesucht – seine „Tonleiter“ –, bei der sich die Folge möglichst schrittweise bewegt (Seriation per Simulated Annealing), und sie mit denselben Symbolen in zufälliger Reihenfolge verglichen. Validierung: Allein aus Notenfolgen findet die Methode die exakte Tonleiter wieder – alle 16 Tonhöhen von 103 Trecento-Oberstimmen (C3–D5, Italien, 14. Jahrhundert) und alle 15 von 600 deutschen Volksliedern (G3–G5), in der richtigen Reihenfolge, ohne die Information, dass es Tonhöhen sind.
Wie melodisch ist die Folge?
Melodik-Index = 1 − (mittlerer Sprung in der besten „Tonleiter“) ÷ (mittlerer Sprung bei denselben Symbolen in zufälliger Reihenfolge). 0 = überhaupt keine Ordnung.
Voynich liegt auf halbem Weg: so geordnet wie eine Chiffre oder der Selbstzitat-Generator, weit entfernt von Musik. Und es bewegt sich einseitig: In Voynich B gehen 69 % aller Schritte in dieselbe Richtung (Melodien: 52–56 %, da sie wieder zurückkommen müssen), und wiederholte „Noten“ sind selten (5 % gegenüber 13–22 %). Die Wörter durchlaufen das Glypheninventar in einer Richtung (q → o → k → e → d → y) und springen dann zurück. Das ist die bekannte „Slot-Grammatik“ der Voynich-Wörter, keine Melodie.
Der Reimtest
Für jedes Paar benachbarter Zeilen in einem Absatz: Teilen ihre letzten Wörter die letzten beiden Glyphen – im Vergleich zu Zeilen, die mindestens vier Zeilen auseinanderliegen? Dasselbe wird für das erste, zweite und vorletzte Wort gemessen, sodass sich die allgemeine Ähnlichkeit benachbarter Zeilen herausrechnet. Reim-Index = Überschuss am Zeilenende ÷ Überschuss an den anderen Stellen. Der Paarreim-Test vergleicht die Zeilen 3–4, 5–6 … mit 2–3, 4–5 … (die erste Zeile eines Absatzes wird übersprungen, sie hat ihren eigenen Wortschatz).
Reimen sich Zeilenenden auf die nächste Zeile?
Reim-Index (1,0 = kein Reim). Der Balken für Parzival ist bei 2 abgeschnitten.
Kein Abschnitt des Voynich-Manuskripts reimt sich – weder im Paarreim (z zwischen −2,7 und −1,1) noch im Kreuzreim (Verhältnis 0,88–1,09 für Zeilen im Abstand von zwei). Gereimte Verse, ein Vers pro Zeile geschrieben, würden sich sogar durch eine Chiffre vom Naibbe-Typ zeigen (z = 21). Zwei Dinge kann dieser Test nicht erkennen: ungereimte Verse (etwa die Hexameter des verbreiteten Kräuterlehrgedichts Macer floridus) und Verse, die als Fließtext abgeschrieben wurden – Parzival, als Prosa umbrochen, erreicht 1,03, wie Voynich.
10 · Durch das Blatt
Noch eine Idee: Was, wenn die Lage im Raum zählt? Welche Glyphen liegen übereinander, wenn man ein Blatt gegen das Licht hält, und welche Wörter verstecken sich hinter einer Zeichnung auf der anderen Seite? Schablonen- und Gitterchiffren, die so funktionieren, sind erst ab dem 16. Jahrhundert belegt (Cardano-Gitter, 1550), ein Jahrhundert nach dem Pergament. Getestet habe ich es trotzdem.
Die beiden Seiten ausrichten
Die Ausrichtung übernimmt das Pergament selbst: Auf dem Scan einer Vorderseite scheinen Farbe und Tinte der Rückseite schwach durch. Ich habe die Skalierung, Drehung und Verschiebung gesucht, bei der diese Geisterbilder mit der gespiegelten Rückseite zusammenfallen (Phasenkorrelation). Bei 44 von 83 Blättern ist der Treffer eindeutig: ein Korrelationsgipfel von 8–24 σ, während die Rückseite eines falschen Blatts nie über 6,4 σ kommt. Die erste Version dieser Seite hatte die Blätter nur an ihren Kanten ausgerichtet und lag im Mittel 65 px daneben (etwa 6 % der Seitenbreite, bis zu 10 %). Die reinen Textseiten des Rezeptteils scheinen kaum durch und lassen sich so nicht ausrichten; der Test unten nutzt deshalb Kräuter-, Bade- und Pharma-Blätter.
Das Blatt gegen das Licht halten
Vorderseite oben, gespiegelte Rückseite darunter, ausgerichtet am Durchscheinen. Vorderseite ausblenden, hineinzoomen (+/−, Strg + Mausrad oder Doppelklick; ziehen zum Verschieben) oder die Ausrichtung selbst nachjustieren.
Ausrichtung nachjustieren
Der Durchlicht-Test
Auf diesen 44 Blättern habe ich jedes transkribierte Wort auf dem Scan verortet (Textzeilen entlang ihrer Krümmung verfolgt, Wörter der Tinte zugeordnet), die Rückseite auf die Vorderseite abgebildet und zwei Fragen gestellt. Die Kontrolle ist dasselbe Blatt mit einer um 2–8 Zeilen verschobenen Rückseite: gleicher Schreiber, gleiches Vokabular, gleicher Aufbau der Zeilen von links nach rechts – nur die physische Überlagerung fehlt. Eine eingepflanzte Beziehung zeigt, wie stark eine echte sein müsste, um aufzufallen.
| Frage | Voynich | Würde gefunden, wenn … |
|---|---|---|
| Ähneln sich Wörter, die übereinanderliegen? 1.385 Paare · gleiches Wort, Variante mit einer Glyphe Unterschied, gleiche oder abhängige erste/letzte Glyphe | p = 0,06–0,98 nichts signifikant | 5 % der Rückseiten-Wörter das Wort dahinter kopieren oder 20 % ihre erste Glyphe davon ableiten (jedes Mal gefunden) |
| Sind Wörter hinter einer Zeichnung anders? 461 Wörter hinter Zeichnungen gegen 1.458 hinter leerem Pergament · Länge, Unikate, häufige „Füllwörter“ | Länge −0,18 Glyphen, p = 0,04 übrige p = 0,57–0,69 | 30 % der Wörter hinter Zeichnungen Füllwörter wären (jedes Mal gefunden) |
Nichts verbindet die beiden Seiten. Der eine nominelle Treffer – Wörter hinter Zeichnungen sind 0,18 Glyphen kürzer – übersteht die Korrektur für drei getestete Maße nicht, und Wörter neben einer Zeichnung sind ohnehin kürzer (siehe unten). Grenzen: Die Wortpositionen stammen aus automatischer Zeilenverfolgung und liegen stellenweise etwa ein Wort daneben, was eine echte Beziehung verwässern würde; die eingepflanzten Tests setzen eine korrekte Verortung voraus.
Wo Text auf eine Zeichnung trifft
In 588 Zeilen unterbricht eine Zeichnung den Text (1.270 Wörter berühren eine Zeichnung). Verhalten sich diese Wörter wie Zeilenanfänge und -enden – oder wie gewöhnliche Wörter in der Zeilenmitte?
| Position des Worts | beginnt mit y/s | beginnt mit Galgen p/t | endet auf -m | Wort kommt nur einmal vor |
|---|---|---|---|---|
| Zeilenanfang | 15,5 % | 17,1 % | 0,5 % | 21,9 % |
| Direkt nach einer Zeichnung | 24,4 % | 0,2 % | 0,5 % | 15,8 % |
| Zeilenmitte | 5,9 % | 3,2 % | 1,4 % | 10,5 % |
| Direkt vor einer Zeichnung | – | – | 2,8 % | 16,0 % |
| Zeilenende | – | – | 16,0 % | 22,1 % |
- Eine Zeichnung startet den Text neu wie eine neue Zeile – Wörter direkt danach beginnen sogar häufiger mit
y/sals Wörter am Zeilenanfang. - Aber nie mit einem Galgen
p/t: Die gehören an den linken Rand, an den Beginn von Zeilen und Absätzen. - Das Zeilenende überträgt sich nicht. Vor einer Zeichnung ist
-mselten (2,8 % gegen 16 % am Zeilenende). Die Zeichnungen kamen zuerst, der Schreiber wusste also, dass die Lücke kommt:-mhängt am rechten Rand, nicht am Platzmangel. - Wörter an einer Zeichnung sind etwas häufiger Unikate – ein Randeffekt, keine versteckten Beschriftungen.
11 · Geschichte, Besitzer, fehlende Blätter
- 1404–1438 – Pergament per Radiokarbonmethode datiert (University of Arizona, 2009). Kleidung und Frisuren passen zu etwa 1420–1440. Mindestens 14–15 Kalbshäute; fünf Schreiber (L. F. Davis, 2020).
- um 1440–1600 – keinerlei Spur.
- 1599 – Kaiser Rudolf II. zahlt Carl Widemann 600 Gulden für „ein Fässchen mit einigen bemerkenswerten Büchern“. Die einzige dokumentierte Transaktion, die zur späteren Geschichte von den „600 Dukaten“ passt; die Verbindung zu diesem Manuskript ist unbewiesen.
- frühes 17. Jh. – der Name von Jacobus Horčický de Tepenec, Leiter von Rudolfs botanischen Gärten, auf f1r (unter UV-Licht sichtbar).
- 1607–1611 – Rudolfs Kunstkammer-Inventar (heute in Vaduz) verzeichnet kein Buch in unbekannter Schrift oder Chiffre.
- 1639 – früheste sichere Erwähnung: Der Prager Alchemist Georg Baresch bittet Athanasius Kircher in Rom um Hilfe.
- 17. Jahrhundert – Blattnummern hinzugefügt. 14 nummerierte Blätter, darunter zwei ganze Lagen, gingen danach verloren (Davis), also nach Rudolfs Zeit. Wohin sie gelangten, ist unbekannt.
- 1648 – Das schwedische Heer plündert Rudolfs Bibliothek in Prag (10.000–11.000 Bände nach Stockholm; später über Königin Christina nach Leiden und in den Vatikan). Das Manuskript war bereits anderswo.
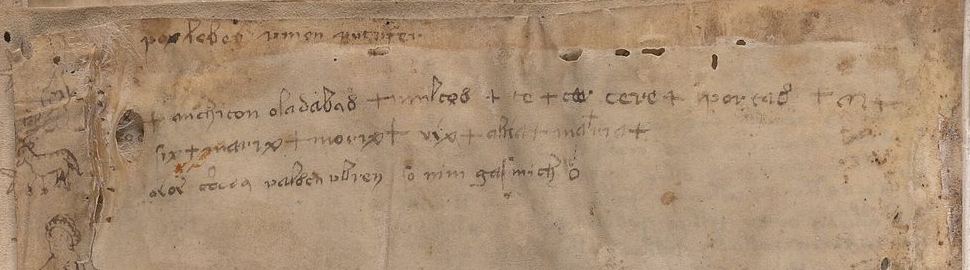
- 1665/66 – Johannes Marcus Marci schickt das Buch an Kircher. Multispektralaufnahmen zeigen Marcis eigene, ausradierte Buchstabenspalten auf f1r – ein früher Entschlüsselungsversuch (identifiziert 2024).
- 19. Jahrhundert – in Rom neu in einen weichen Pergamenteinband gebunden, vermutlich von den Jesuiten.
- 1912 – Wilfrid Voynich kauft es von den Jesuiten (Villa Mondragone).
- 1961 / 1969 – Hans P. Kraus kauft es, findet keinen Käufer und schenkt es Yale.
- 2009 – McCrone-Analyse: durchgehend Eisengallustinte, mineralische Pigmente, nichts Anachronistisches. Die Tinte selbst lässt sich nicht datieren; das Pergament war zuvor nicht beschrieben worden.
Kein zweiter Text in dieser Schrift ist bekannt – nur spätere Abschriften durch Besitzer (Bareschs Proben, Marcis Spalten).
12 · Hypothesen-Übersicht
| Hypothese | Status | Begründung |
|---|---|---|
| Buchstaben- oder Glyphengruppen-Substitution von Latein, Italienisch, Deutsch, Mittelhochdeutsch, Griechisch, Okzitanisch, Altfranzösisch, Katalanisch | ✕Ausgeschlossen | Kontrollen zu 94–100 % geknackt; Voynich schlägt den gemischten Voynich-Text nie über das Rauschen hinaus. |
| Periodischer oder positionsabhängiger Schlüssel (Vigenère, Trithemius, laufender Schlüssel inkl. Bibel, Schlüssel pro Seite, Zeilenindikator nach Alberti) | ✕Ausgeschlossen | Entgegengesetzter Fingerabdruck; keine Periode 2–40; Wörter kehren unverändert auf anderen Seiten und zwischen A/B wieder. |
| Aufblähende Chiffre vom Naibbe-Typ für gewöhnliche Prosa | !Geschwächt | Keine Wortgrenzen-Abhängigkeit, keine Beinahe-Kopien, Einwort-Beschriftungen zu kurz. |
| System mit fester Schreibung, in dem Pflanzennamen wiederkehren | !Geschwächt | Pharma-Beschriftungen fehlen auf den passenden Seiten des Kräuterteils. |
| Chiffre mit Gedächtnis (Wortende wählt die nächste Tabelle) | ?Offen | Erklärt den Wortgrenzen-Effekt; Version auf Buchstabenebene negativ, Version auf Wortebene bei dieser Textlänge nicht testbar. |
| Listen systematisch gebildeter Wörter (Namen, Begriffe, Rezepte) | ✓Vereinbar | Passt zum Beinahe-Kopie-Muster, zum listenartigen Layout und zu den Regeln auf Zeilenebene. |
| Generierter Text ohne Bedeutung (Selbstzitat) | ✓Vereinbar | Passt zum Beinahe-Kopie-Muster; erklärt für sich allein nicht die Querverweise zwischen den Bildern. |
| De balneis Puteolanis als Klartext des Badeteils | ✕Ausgeschlossen | Abschnittslängen passen nicht zusammen (p = 0,72; der Test findet die echte Quelle in 100 % der Fälle); zu kurz für eine Chiffre vom Naibbe-Typ. |
| Antidotarium Nicolai als Klartext des Rezeptteils | ✕Ausgeschlossen | Kein Alignment in 8 Varianten (p ≥ 0,28; Teststärke 100 % bis ±50 % Längenänderung pro Rezept). Nur eine stark reduzierte Auswahl von Rezepten ist nicht ausgeschlossen (Teststärke 58 %). |
| Notenschrift (eine Glyphe = eine Note) | ✕Ausgeschlossen | Weit weniger schrittweise als echte Melodien und, wie die Slot-Grammatik, stark in eine Richtung laufend. |
| Gereimte Verse, ein Vers pro Zeile | ✕Ausgeschlossen | Zeilenenden reimen sich nicht (Paarreim-Test z ≤ −1,1; gereimte Verse durch eine Naibbe-Chiffre: z = 21). Ungereimte Verse bleiben ungetestet. |
| Schablonen- oder Durchlicht-Beziehung zwischen den beiden Seiten eines Blattes | ✕Ausgeschlossen | Auf 44 Blättern über das Durchscheinen ausgerichtet: übereinanderliegende Wörter ohne Zusammenhang (p ≥ 0,06), Wörter hinter Zeichnungen nach Korrektur nicht anders; eine Kopierbeziehung für 5 % der Wörter hätte sich gezeigt. |
| Nomenklator / Codebuch, abgekürztes Latein, Buchchiffre, andere Sprachen (Hebräisch, Tschechisch …) | ?Ungetestet | Erfordern Cribs, spezielle Korpora oder das Schlüsselbuch. |
13 · Zum Nachrechnen
Alle Skripte (Python + ein kleiner C-Löser) stecken in voynich-analysis-code.zip, samt README. Verwendete Datenquellen:
- Transkription: Takahashi-EVA-Zeilen aus Stolfis Interlinear-Archiv (
text16e6.evt) über voynich2vec. - Tabellen und Code der Naibbe-Chiffre: github.com/greshko/naibbe-cipher (Greshko 2025, Cryptologia).
- Selbstzitat-Generator: TorstenTimm/SelfCitationTextgenerator.
- Sprachmodelle: Latein (Vulgata, Bruno, Caesar, Censorinus, Trithemius, Secretum secretorum), Italienisch (Dante), Deutsch (Luther 1545) aus voynich2vec; Mittelhochdeutsch aus der MHDBDB; Altgriechisch (Galen, Aristoteles, Neues Testament); Altokzitanisch aus HTRogène; Altfranzösisch UD SRCMF; Katalanisch UD AnCora.
- Quelltext-Kandidaten: Petrus de Ebulo, De balneis Puteolanis (lateinischer Text, 34 Abschnitte inkl. Prolog und Widmung); Antidotarium Nicolai, Druck Venedig 1471 in der Edition von W. S. van den Berg (1917), archive.org.
- Musik: Trecento-Stücke und Volkslieder der Essen-Sammlung aus dem music21-Korpus; gereimte Verse: Wolfram von Eschenbach, Parzival, aus der MHDBDB.
- Scans: Beinecke MS 408 über den Voynich Atlas (gemeinfrei).
Grenzen dieser Studie
Die stochastische Suche kann eine Lösung verfehlen (Erfolgsquote pro Neustart bei den Kontrollen: etwa 15–90 %, daher 8–24 Neustarts pro Lauf). Die Sprachmodelle beruhen auf edierten modernen Texten, nicht auf abgekürzter mittelalterlicher Handschrift. Der Pflanzenabgleich ist subjektiv (daher die vorab festgelegte Liste und die abgestufte Sicherheit). Alle transkriptionsbasierten Ergebnisse erben die Unsicherheiten von EVA, besonders bei den Wortabständen. Die Quelltext-Alignments setzen voraus, dass Voynich-Absatzumbrüche mit Abschnittsgrenzen der Quelle zusammenfallen und dass die Chiffre die relative Länge grob erhält; der Reimtest setzt einen Vers pro Zeile voraus.
Literatur
- Greshko, M. A. (2025). The Naibbe cipher. Cryptologia. doi:10.1080/01611194.2025.2566408
- Timm, T. & Schinner, A. (2020). A possible generating algorithm of the Voynich manuscript. Cryptologia 44(1). doi:10.1080/01611194.2019.1596999
- Davis, L. F. (2025). Voynich codicology; (2024) Multispectral imaging and the Voynich Manuscript.
- Zandbergen, R. voynich.nu – Herkunft, Geschichte, Rudolfs Kunstkammer-Inventar.
- Der McCrone-Bericht (2009) zu Tinten und Pigmenten.
- Book transactions of Emperor Rudolf II, 1576–1612.
- Beinecke Library: das Voynich-Manuskript.